
SPCX
Deep|SPCX: Grok 4.5让SpaceXAI 重新回到 Frontier Lab 牌桌;继续看好 harness 数据飞轮与算力需求
Andy
Grok 4.5 这次发布最大的意义,是 xAI / SpaceXAI 重新回到了北美 frontier lab 的牌桌上。年初大家看北美 frontier model race 还是 OpenAI、Anthropic、Google、Meta、xAI 五家,但中间一段时间 xAI 明显掉队,市场更愿意把它看成一个新的 neocloud,叙事一度从五家变成四家。前不久 Meta 又传出要做“Meta Compute”、把多余 AI 算力拿出来卖,市场把这件事理解成 frontier lab 缩圈、算力过剩、利空 neocloud 和 AI infra。
Grok 4.5: near-frontier但明显更便宜
但 Grok 4.5 发布后,这个判断要修正:xAI 还没有全面超过 OpenAI / Anthropic / Google,但它至少证明自己可以重新做出接近 frontier 的模型。Grok 4.5 官方定位就是 coding、agentic tasks 和 knowledge work,API 价格是 $2/M input、$6/M output,且官方强调在同等任务上 token efficiency 大概是 comparable leading models 的 2x。AA 给 Grok 4.5 的 Intelligence Index 是 54,排第 4,只落后 Fable 5、GPT-5.5 和 Opus 4.8。
Source: Artificial Analysis
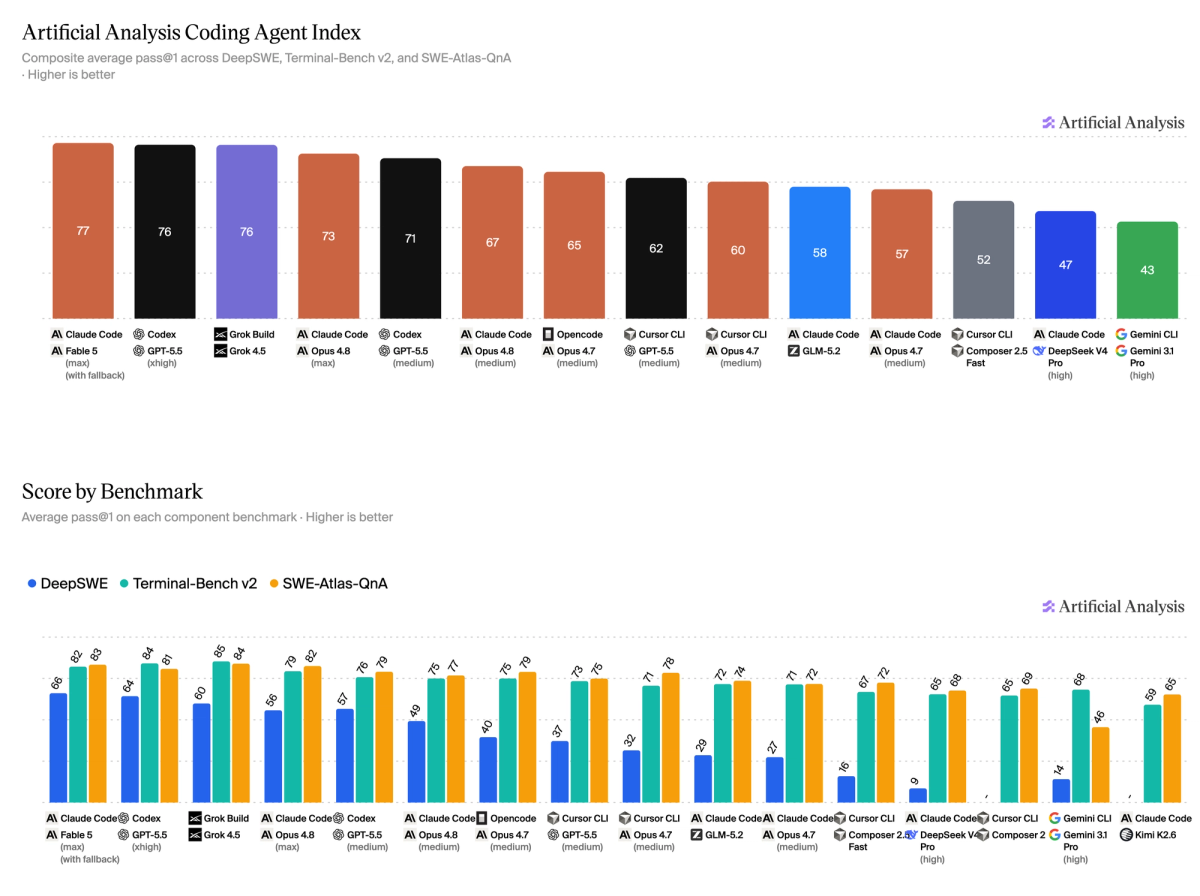
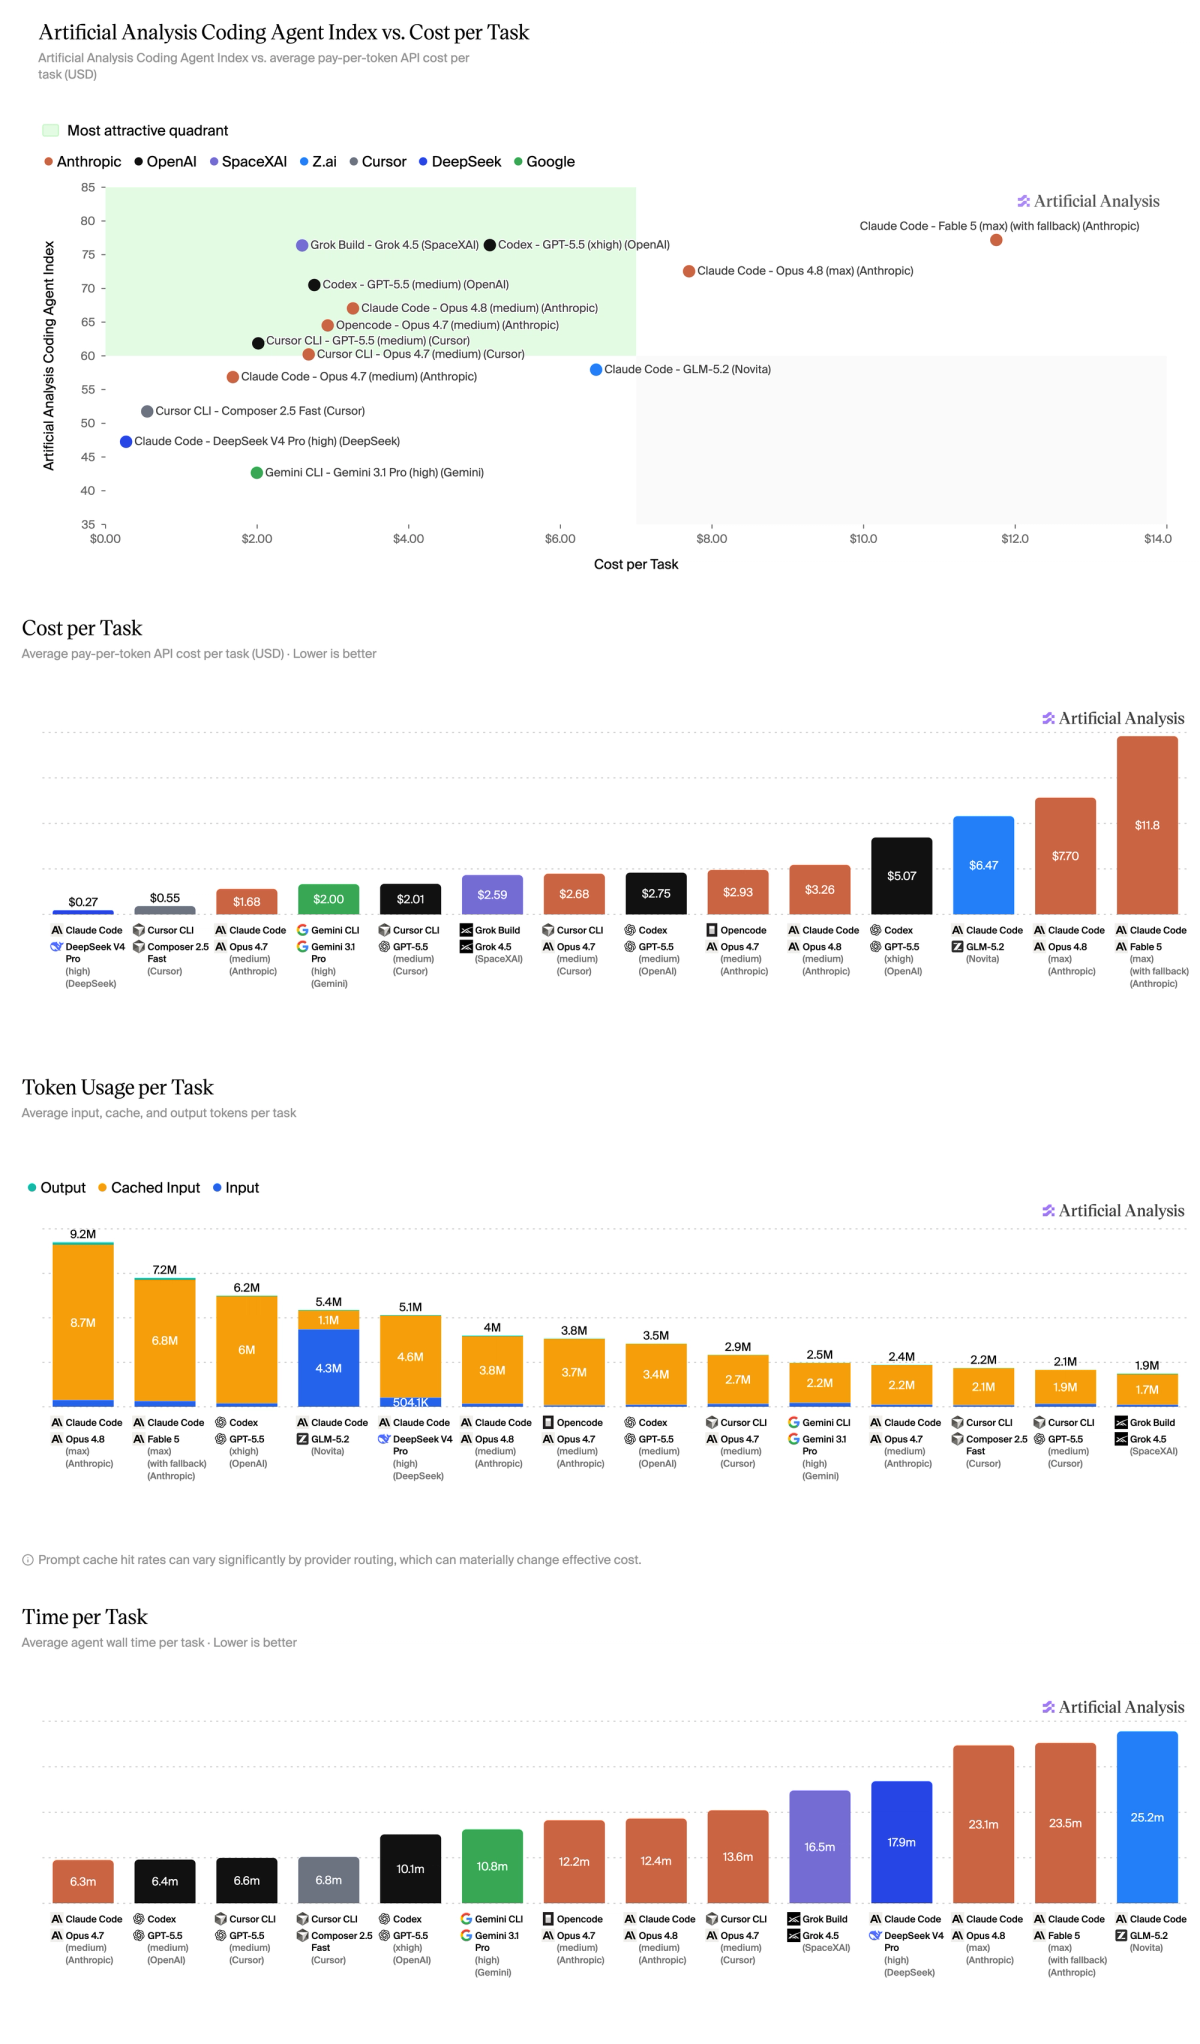
细看 benchmark,重点放在真实 engineering 和 agent work:Terminal-Bench 2.1 上 Grok 4.5 是 83.3%,基本贴着 GPT-5.5 的 83.4% 和 Fable 5 的 84.3%;DeepSWE 1.0 上 Grok 4.5 是 62.0%,低于 Fable 5 的 66.1% 和 GPT-5.5 的 64.3%,但明显高于 Opus 4.8 的 55.8%;SWE-Bench Pro 上 Grok 4.5 是 64.7%,低于 Fable 5 / Opus 4.8,但高于 GPT-5.5 的 58.6%。AA 的 coding agent 口径更能解释市场为什么重视:Grok 4.5 in Grok Build 在 Coding Agent Index 拿到 76,基本和 GPT-5.5 in Codex 同档,只低于 Fable 5 in Claude Code;但每个 coding-agent task 成本只有 $2.49,低于 GPT-5.5/Codex 的 $5.07,更远低于 Fable 5/Claude Code 的 $11.80。也就是说,Grok 4.5 的卖点不是单项最高分,而是“near-frontier + 明显更便宜 + token 用量更少”。
Source: Artificial Analysis
Continue reading with FUNDA
This report is available to subscribers. Sign in or subscribe to read the full analysis.