
NVDAGOOGL
[Deep] DeepSeek V4:第一个为了非Nvidia芯片定制的模型,成本极致优化
Andy
DeepSeek V4's sparse attention + MegaMoE cuts KV/mem traffic, unlocking cheap Ascend-scale inference.
DeepSeek V4这次的重点,不只是模型能力提升,也不只是支持更长上下文。更值得关注的是,它看起来明显在向非Nvidia GPU的AI芯片和ASIC进行了深度定制,其中最主要的应该就是华为昇腾。V4的架构选择,明显适合在非Nvidia GPU的硬件和集群环境里运行。
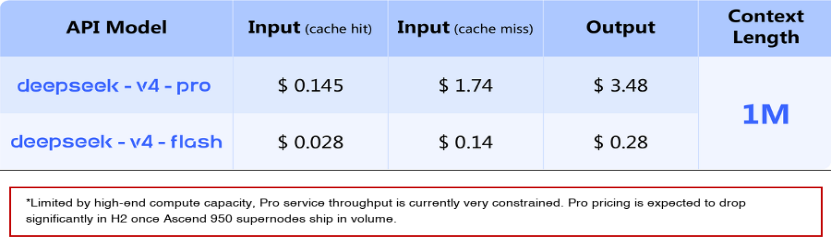
来源: DeepSeek V4技术报告
过去大模型架构默认是围绕NVIDIA生态优化的。CUDA、Triton、FlashAttention、PagedAttention、NVLink、NVSwitch,这些基本都是默认前提。模型公司先把模型做好,再交给NVIDIA生态里的各种kernel和推理框架去榨性能。
但其他AI芯片和ASIC的问题是,它没有NVIDIA这么成熟的软件生态。比如,昇腾更依赖规则的大块矩阵计算,更怕复杂的小算子、频繁的数据搬运、复杂的attention路径和不成熟的kernel优化。所以,如果把一个高度NVIDIA优化的大模型直接搬到类似昇腾的AI芯片和ASIC上,通常效率会大打折扣。能跑是一回事,跑得便宜、稳定、高效,是另一回事。
V4有意思的地方就在这里。它看起来不是简单把V3/R1继续放大,而是在模型架构上做了很多“非Nvidia硬件友好”的选择。
Continue reading with FUNDA
This report is available to subscribers. Sign in or subscribe to read the full analysis.